
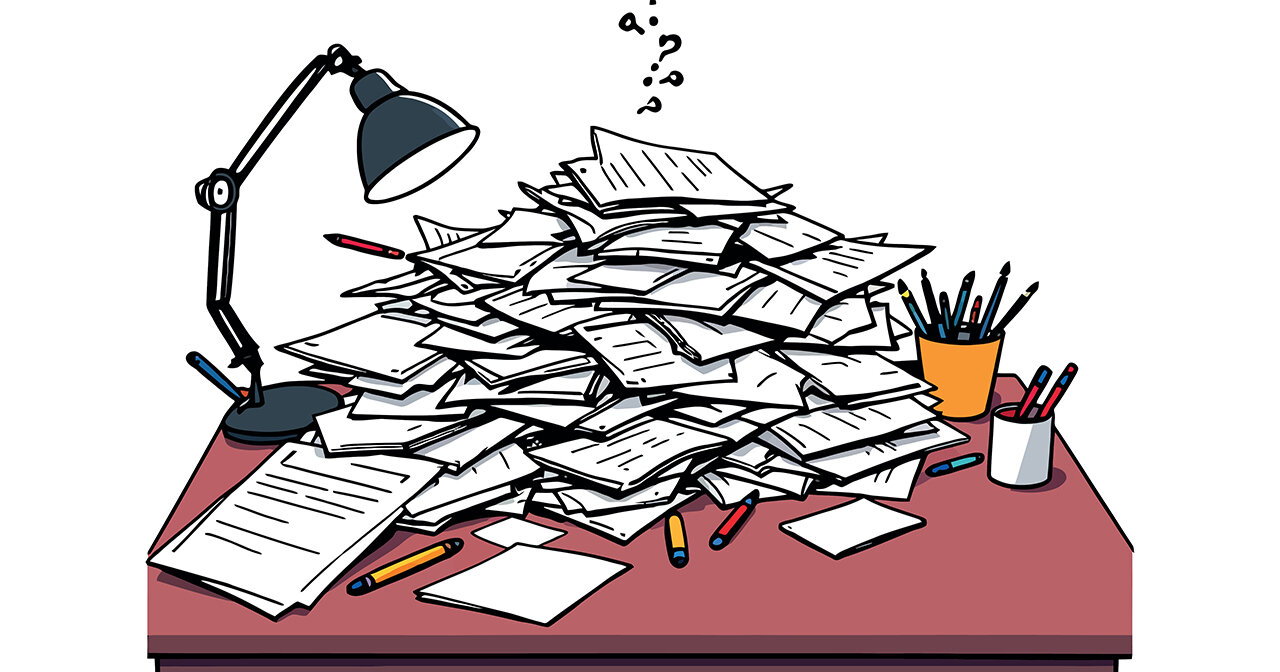
情報を置く場所で分ける
さて、では実際にどうやって賢くコンテキストを管理すればよいかを考えていきましょう。とはいっても、基本の考え方は1つです。必要な情報を、必要なときだけ載せること。
今回は、机の上、引き出し、倉庫、そして別の机の4つに情報を分けることで、机の上の情報密度を高く保つ例を紹介します。Claude Codeを想定した話になりますが、「情報を分ける」という考え方は他のAIでも共通です。
今回は、机の上、引き出し、倉庫、そして別の机の4つに情報を分けることで、机の上の情報密度を高く保つ例を紹介します。Claude Codeを想定した話になりますが、「情報を分ける」という考え方は他のAIでも共通です。
机の上
AIが作業に使う「机の上」に置く資料は、常に今、その瞬間に必要な情報だけであるべきです。
あなたが入力欄に貼り付けようとしている長文のログ、それは本当に全部必要な情報でしょうか? 一旦ファイルに書いておき、AIに必要な部分だけ検索させるという手もあります。
意外と見落とされがちなのは、AI自身の出力。これも全部机に載ります。不必要に長い回答は控えさせるべきです。出力スタイルを設定したり、プロンプトで指示したりするなど工夫しましょう。
そして忘れてはならないのが、設定ファイルのCLAUDE.mdです。これは毎回必ず読まれるものなので、その分量はコンテキストにダイレクトに響きます。Claude Code公式の推奨は200行以下で、私のは先ほど確認したら90行くらいでした。CLAUDE.mdを短くするコツは、このあと紹介します。
引き出し
いますぐ必要でないものは「引き出し」にしまっておき、必要になって初めて取り出すのがよいですね。わかりやすい実例はスキルです。
個々のスキルには具体的な手順や参照ファイルがありますが、AIが最初から全てを把握する必要はありません。「何があるか」と「いつ使うか」さえわかっていれば、あとは必要になった時に手順を確認すればいいのです。
Claudeのスキルは実際にこの思想に沿った構造になっていて、名前と簡単な説明だけが最初から見えていて、中身は使うときに初めて読まれる設計になっています。ちなみにMCP(Model Context Protocol:AIに外部のツールやデータをつなぐ規格)のツールも同じ構造です。
皆さんが意識すべきことは簡単で、SKILL.mdのdescriptionには「いつ使うか」だけ書いておき、残りは全部本体に書くこと、特定のタイミングでのみ必要な決まりはCLAUDE.mdからスキルへ移すことです。
それともう1つ。実は、CLAUDE.mdは複数あってもいいとご存じでしたか? 共通ルール以外の設定情報は、例えばプロジェクトのフォルダごと、さらにその中のフロントエンドとバックエンドのフォルダ別など、フォルダ階層ごとにCLAUDE.mdとして置くことができます。
階層化されたCLAUDE.mdは、Claudeがそのフォルダの中に初めて来たときに自動的に読まれる仕組みなので、その場所固有のルールや情報を分散して置くことで、効率よくコンテキストを管理できます。
倉庫
スキルやMCPは、存在だけは常にAIに把握しておいてもらいたいところですが、情報の中にはそもそも存在さえ知らなくていいものもあります。機能の詳細な文書や大きなログは普段見せないで「倉庫」にしまっておき、必要な時に人間側が名指しで指定することでAIの意識がそれることを防げます。ちなみにスキルにも、名指しするまではAIから見えなくする設定があります。ぜひお手元のClaudeにやり方を聞いてみてください。
AIから隠すという観点では、スクリプトも非常に強力です。スクリプトはあらかじめ決められた手順どおりに動き、処理をするプログラムで、LLMは入力と出力さえ知っていれば使えます。わざわざコードの中身を読んで理解する必要はないのです。
いままではスクリプト作成というと、どうしてもハードルが高かったのですが、最近はAIで簡単に作成できるようになりました(良い時代です!)。決まった作業はどんどんスクリプト化しましょう。
AIから隠すという観点では、スクリプトも非常に強力です。スクリプトはあらかじめ決められた手順どおりに動き、処理をするプログラムで、LLMは入力と出力さえ知っていれば使えます。わざわざコードの中身を読んで理解する必要はないのです。
いままではスクリプト作成というと、どうしてもハードルが高かったのですが、最近はAIで簡単に作成できるようになりました(良い時代です!)。決まった作業はどんどんスクリプト化しましょう。
別の机
調べ物や設計をするのに一度資料を広げる必要がある。でも必要な結果は3行で、そのほかは結果が得られた後はもう使わない……。
このような場合は、そこだけ「別の机」で作業して、結果だけをメインの机に持ち帰るという手法が有効です。Claudeには「サブエージェント」(指示した作業だけを別枠で処理し、結果だけを本体に返してくれる補助のAI)という形で実装されています。
調査を別の机でやらせれば、向こうの机は散らかっても、こちらは散らかりません。調査に6000トークン使って、最後に返ってきたのは400トークンだったという実例もあります。思い出してください。作業自体に必要な資料の総量は変わりませんが、メインの机に積んである資料は以降のターンでも毎回全部読まれることを……。メインで作業している机に直接どっさり資料を載せるよりは、別の机で調べ物を済ませ、要点だけ紙1枚にまとめて持って帰ってくる方が作業はしやすいですよね。
サブエージェントが有効な場面としては、独立した調査やレビュー、テストの実行といった、最終結果だけがわかればいいというものが主に挙げられます。ただし、あまりにも細かい作業は伝達のコストが勝ってしまいます。また、並列で書き込みを伴うような作業では競合が発生するので注意が必要です。
キャッシュの話
最後にちょっとコンテキストから離れて、キャッシュについて紹介させてください。
冒頭で、AIは今までのやり取りを毎回全部読み直して送っていると書きました。ですが実際は、前回と変更がない部分はキャッシュという仕組みで再利用されています。キャッシュが成功した入力は通常の約10分の1のコストで計算されます。ただし、情報を先頭から見ていって1カ所でも変更があれば、そこから下は全部キャッシュの作り直しになります。
ところで、コンテキストを圧縮する方法の1つに「/compact」というコマンドがあります。これまでの内容を全部読んで、その要約を作成し、それを新たなコンテキストとする、というものです。便利なコマンドなんですが、1つ問題があります。
それは、/compact がキャッシュを破壊するということです。今までの内容が大きく変化するので、 圧縮した直後から作業を続けると、キャッシュが効かずに意外とコストが高くつくことがあります。ちなみに、あまり知られていませんが、途中でモデルやエフォート(AIがかける労力のレベル)を切り替えたときにも、同じことが起こります。
これは個人的な思想ですが、私は/compact があまり好きではありません。理由は2つあって、1つは上記のようにキャッシュを失うからです。もう1つは、コンテキストを均等に圧縮するので、決めておいたワークフローの一部が削られることがあるからです。1から10まで指定している手順のうち、要約後は3と7だけ抜け落ちるというようなことがたびたび起きるんです。
だから私は、コンテキスト(机の上)が埋まってきたら、引き継ぎ資料を早めに書かせます。そのあと、必要な情報とハンドオフ(引継書)だけ読ませて新しいセッションを再開しています。これならコンテキストに本当に大事な部分だけを引き継いで、作業を継続することができます。
終わりに
ここまで、コンテキストについてさまざまな話を書いてきました。覚えておいてほしい重要なことは1点だけで、「必要な分を、必要な時だけ」という基本の原則です。
真に最適な運用は、人によってもタスクによっても違ってきます。最後に必要になるのは、皆さんがお手元で自分の作業を見直し、1つずつ改善することです。うまくいかないときは「余計なものをコンテキストに持っていないか」 を疑ってみてください。現実のデスクもAIのデスクも整理整頓して、コスパよく仕事をしましょう。
真に最適な運用は、人によってもタスクによっても違ってきます。最後に必要になるのは、皆さんがお手元で自分の作業を見直し、1つずつ改善することです。うまくいかないときは「余計なものをコンテキストに持っていないか」 を疑ってみてください。現実のデスクもAIのデスクも整理整頓して、コスパよく仕事をしましょう。
GMOインターネットグループ Y.U.
グループ研究開発本部 次世代研究開発室
2026年新卒入社。学生時代はブロックチェーンをたしなむ。AIに限らず、超最新技術の業務活用と、情報発信を好む。現場人として、完全自動のAI駆動開発の実現や、自己改善ループを備えたプロダクトの構築を経験。趣味は重量級ボードゲームのプレイと収集。

-
1
ポケポケステップアップバトルが今秋終了!?夏休みはオートデッキでシ...
-
2
ノンフライヤーで「業スー揚げ物」の限界に迫る!業スーの冷凍フライの...
-
3
小学生がどハマりする生成AIキャラクター「イタリアンブレインロット...
-
4

「たこ焼き器」で作る“たこ焼き以外レシピ”は予想以上においしくて楽しい
-
5

お台場発着に決定!日本でも“豪華客船体験”ができる?「ディズニーク...



セキュリティキャンペーンでのバナー
-
1
ポケポケステップアップバトルが今秋終了!?夏休みはオートデッキでショップチケットを取り逃がすな!
-
2
ノンフライヤーで「業スー揚げ物」の限界に迫る!業スーの冷凍フライの逸品5選
-
3
小学生がどハマりする生成AIキャラクター「イタリアンブレインロット」の中毒性と拡散力
-
4
「たこ焼き器」で作る“たこ焼き以外レシピ”は予想以上においしくて楽しい
-
5
お台場発着に決定!日本でも“豪華客船体験”ができる?「ディズニークルーズライン」の価格・アトラクション最新情報